
Day 1,總經理問:開發有沒有變快?維運的人力負擔有沒有降低?
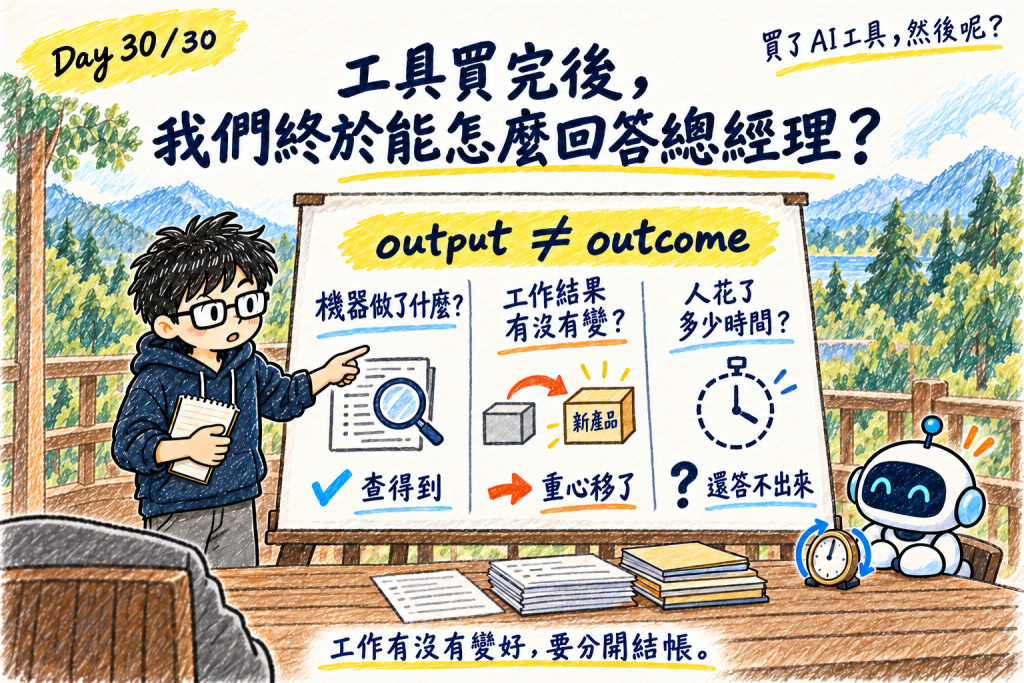
我拿得出使用報表,卻回答不了。三十天下來,我最大的體會是:output 不等於 outcome。 Claude 寫出的程式、提出的修改、跑完的排程,都是 output;總經理問的是 outcome:工作有沒有變好、人有沒有變輕鬆。昨天的迴圈也一樣,它準時提出下一步,我卻沒有比較輕鬆。
所以今天分開結帳。Day 1 的五層問題,收成三題:① 機器做了什麼(output)、② 工作結果有沒有變(outcome)、③ 人花了多少時間(代價)。順序是先看機器、再看結果、最後算代價。
先說結論:人變少了,交付沒有掉,重心還移到了新產品,維運新單也結得更快;但人省了多少時間,還答不出來。 這篇是整個系列的總結帳;只想看一段,先看 ② 的兩隊對照。
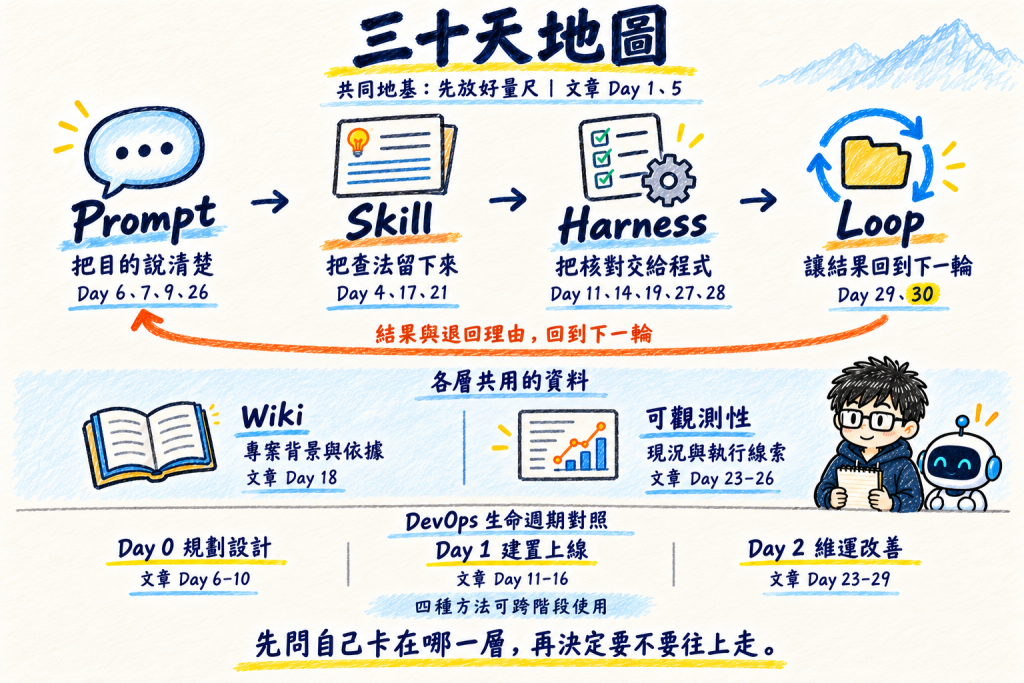
下方共用資料區的 Wiki 和可觀測性,是每一層都能取用的資料:Wiki 給專案背景,可觀測性給實際運行的線索。
下面三題的證據,就落在這張地圖上:
| 題目 | 對應 Day 1 | 地圖上看哪一層 | 本篇的證據 |
|---|---|---|---|
| ① 機器做了什麼? | L1 有沒有在用、L2 交出來能不能接受 | Harness 留下的紀錄 | OTel 遙測:權限被拒、重複開單 |
| ② 工作結果有沒有變? | L5 開發與維運有沒有變好 | Prompt 到 Harness 疊起來之後的交付 | Day 26 教學案例;公司的交付與維運趨勢 |
| ③ 人花了多少時間? | L3 人有沒有變輕鬆、L4 值不值得 | Loop 那一層的裁決 | 改善提案的裁決積壓;回本門檻 |
我也回看了官方使用後台與 Day 30 收到的 OpenTelemetry 遙測。它們可以提供工具活動與成本線索,卻不能單靠這些事件回答工作結果。
拿 Day 28 兩組案例重跑:C1 是權限被拒的那組,A1 是兩輪排程重疊、重複開單的那組,r1、r2 是第幾輪。收到的事件節錄如下(欄位順序重排,身分欄位已遮):
C1 r1  tool_decision  tool_name=Bash  decision=reject  source=config
C1 r1  api_request    model=claude-sonnet-5-5  cost_usd=0.0179
A1 r1  tool_decision  tool_name=Bash  decision=accept  source=config
A1 r1  tool_result    tool_name=Bash  success=true  duration_ms=40813
A1 r2  tool_result    tool_name=Bash  success=true  duration_ms=40866
看第 1 行的 decision:C1 那次權限被拒,排程只看得到退出碼,而它是 0;遙測卻留下一筆 reject。再看第 4、5 行:A1 兩輪的開單指令都是 success=true,可是開出的 4 張單是重複的,遙測裡沒有任何一欄看得出來。
執行紀錄、外部工作結果、人工投入,要能對到同一件事。 退出碼看不到的拒絕,可以從工具事件補查;重複開單,要查外部系統;人花多少時間核對與清理,還得另外記。工具執行秒數不能直接當成人工節省。
先看一個能重驗的教學案例,再看公司的真實工作。
Day 26,訂單服務的 CPU 不忙,取消請求卻卡住。給 Claude 的調查要求是這段:
服務在併發取消時變慢,CPU 卻不忙。先提出至少兩個原因,各寫出什麼結果會推翻它。……查不到就列缺件。不要修改程式。
Claude 查指標、堆疊與程式,找到同步等待占住執行緒的位置,再把等待改成 await。
同樣用 96 個併發工作者取消 384 張不同訂單,第一版修完,兩輪都拿到 384 筆 HTTP 200,p95 回應時間約半秒。
但 Claude 的修法說明自己寫了一句:「這個競態原本就存在,我沒有處理,因為它超出最小修法。」也就是同一張訂單同時取消,可能重複通知。我把這個風險做成測試,讓 16 個請求同時取消同一張新訂單,接收端真的收到 16 筆通知。
規格原本寫的是:真正取消一次,只能通知一次。於是把結果交回 Claude,補上同一把鎖內的重新讀取、判斷與更新,再跑一次。
兩版的差別在鎖的範圍:第一版的讀與寫各鎖各的,中間的判斷沒有鎖住;第二版把三步放進同一把鎖。看兩版的 lock 包住了幾行。
// 第一版:等待改成 await,變快了;但讀、判斷、寫分開,同單併發仍會重複通知
await CustomerHistory.FetchAsync();
lock (_g) current = _d[id];                   // 鎖內讀
result = Cancellation.Cancel(current);         // 鎖外判斷:兩個請求可能同時走到這裡
lock (_g) _d[id] = result.Order;              // 鎖內寫

// 第二版:讀取、判斷、更新放進同一把鎖
lock (_g)
{
    current = _d[id];
    result = Cancellation.Cancel(current);
    if (Cancellation.Transitioned(current, result)) _d[id] = result.Order;
}
| 同一組教學負載的核對項目 | 故障版本 | 第一版:改成非同步等待 | 第二版:補原子操作 |
|---|---|---|---|
| 不同訂單取得 HTTP 200 | 321/384 | 兩輪皆 384/384 | 兩輪皆 384/384 |
| 客戶端 p95 | 約 30 秒 | 0.56~0.58 秒 | 0.57~0.59 秒 |
| 同單 16 併發,接收端通知數 | 未測 | 兩輪皆 16 筆 | 兩輪皆 1 筆 |
| 是否接受 | 未通過 | 未通過 | 通過本次條件 |
第二版每輪 13 項檢查通過。三輪診斷與兩版修復的 CLI 回報費用合計約 US$0.78。
這就是箭頭回到第二幕(Day 6–16)的樣子:Day 6 約好的完成條件,在 Day 26 變成攔下第一版的測試。它也改變了我收成果的順序:先確認原本的承諾仍成立,再看變快的數字。
這是本機 .NET 教學服務的故障注入與修復,p95 的故障值也受 30 秒逾時上限影響。它沒有證明正式服務的容量、跨多台機器的一致性,或整段事故處理省了多少人時。
能直接對到 Claude Code 的,是 ① 的遙測與上面的教學案例;以下是整個團隊導入 AI 工具的結果,拆不出 Claude 單獨的份量。《研發交付流程儀表板》整理的兩季資料,先給我一個提醒:開發活動與交付結果,可能往不同方向走。
| 項目 | Q2 對 Q1(以工作天校正) |
|---|---|
| 開發活動(Commit) | 約 +27% |
| 完成合併的 PR | 約 −3%,可視為持平 |
開發活動多了快三成,完成合併的 PR 卻持平。這段期間還有同事陸續離開,完成的 PR 卻沒有跟著掉,比「留下的人數比例 × 導入前人均 PR」的推算多約兩成(人數為內部資料,無法外部複驗)。
但把 PR 拆開看,變的不是總量,是流向:新產品的交付佔比,從一成拉到四成五。 舊產品線有增有減,時間移到了新產品上。
單張開發單倒沒有變快:已結案開發單的中位數是 9.4 天與 9.2 天;上線環節有改善訊號,但轉折略早於導入。
所以我會把「開發有沒有變快」答成:總量持平,重心轉移;單張工作沒有變快,同樣的人做了不同的事。 這些變化不能全歸因於 AI;PR 大小、產品階段與人力配置也都沒有控制。
最反直覺的一組,來自兩個團隊的對照:AI 使用程度與審查方式幾乎一樣,流入的工作量卻不同,結果也相反。 先看「錯誤單流入」那一列。
| 兩隊對照(2026 年 1~8 月,以 4 月中為前後分界;樣本為同期完成的 PR 與工單,各數千筆) | 變快的一隊 | 變慢的一隊 |
|---|---|---|
| AI 參與的 PR 佔比 | 約 79% | 約 84% |
| 人工審查核准率(Claude 審查 bot 上線後) | 下降約 36 個百分點 | 下降約 31 個百分點 |
| 任務週期中位數 | 縮短約 64% | 拉長約 167% |
| 錯誤單流入 | 減少約一半 | 增加約 2.5 倍 |
| 錯誤修復週期 | 拉長約 11% | 拉長約 41% |
兩隊都高度使用 AI,取代大部分人工審查的,也都是同一個以 Claude 跑的審查 bot;差在流入的工作量,變慢那隊同期新案件還多了約七成。兩隊的錯誤修復也都沒有變快。DORA 2025 把 AI 稱為放大器,流程與負荷撐得住的團隊更快,撐不住的更慢;這兩隊看起來就是這樣,但成因報告還沒證實。
同一份流程儀表板裡,一類問題回報的新案件有這個變化:
| 一類問題回報的新案件 | 5 月 → 6 月 |
|---|---|
| 案件數 | 約 +35% |
| 開單到結案的中位數 | 5.1 天 → 3.0 天 |
新案件結得更快,案件也變多了。但結案時間包含等待,不是工時;另一類維運單的結案時間反而拉長。
目前能說的是這批案件較快結案;維運人力是否減載,仍然沒有足夠證據。
人的工作方式確實變了,例如有審查 bot 的團隊,人工核准變少;但少一次核准,不能換算成省下幾分鐘。直接問人也不準:METR 2025 的隨機對照實驗裡,資深開發者覺得自己快了兩成,實測卻慢了約兩成。所以這一題我不拿問卷當答案。
昨天的迴圈證明,退回的理由能帶進下一輪,讓 Claude 換個做法。但「不同意」三個字沒有寫出風險判準,下一次仍要靠我補充,裁決的工作沒有消失。
放大到實際的工作看板更清楚:兩個月提出 30 張改善提案,我裁決了 13 張,最早一張等了 55 天。提案準時來,裁決卻沒有排進固定節奏。 昨天的「更忙」,量到的是待決工作在累積,不是工時。
這也是我下一季要補的量法:挑一件反覆發生、結果查得到的工作,開始前先寫下要改善什麼、跟什麼比、誰接受;人的準備、核對、返工時間分開記,沒記到就留空,不事後補估。如果你也要回答自己的總經理,可以從同一件事開始。
拿給總經理,他只會再問一句:「這筆錢划不划算?」
| 經營者問的 | 目前知道的 | 還缺的 |
|---|---|---|
| 花了多少 | 訂閱費固定;6 月提問數是 4 月的 3.7 倍,每次提問的成本降了約七成 | 導入、核對、返工的人工 |
| 何時回本 | 報告估算:每人每月省下不到一天就打平 | 人實際省了多少時間 |
「回本的門檻不高,但我們還沒量過有沒有跨過去。下一季,我們先把人的時間量出來,再回來跟您報告。」
寫到這裡我才發現,Day 1 的問題本身要改。「開發有沒有變快、人力有沒有降低」,假設的是 AI 用來省人;三十天的資料卻告訴我,它改變的是人的時間花在哪裡。下一次回報,我想換一個問題:同樣的人,時間有沒有移到更值錢的事情上?
三十天前那場主管會議,我報完使用量,會議室安靜了一下。我回答的是「大家用了多少」,總經理問的是「工作變好了多少」。
如果下週再開一次會,我會帶三樣東西進去:一張機器查得到的紀錄、一張交付與維運的趨勢,還有一個空格,上面寫著「人省了多少時間:下一季量」。
那個空格,是我三十天前不敢承認的東西。現在我知道,它不是報告的缺陷,而是下一步該花錢的地方。要量的人工時間,我會和 Claude 留下的工具事件、退回理由與裁決紀錄對到同一件事:哪一次核對、哪一次返工,對應到哪一輪輸出。
會議室也許還是會安靜一下。但這一次,我知道自己在等什麼答案。這個系列寫到這裡結束,剩下的就是把那個空格填上。
產出可以交給 AI,成果只能由人負責。
圖中標的是代表篇章;這份索引收齊 Day 1–30。可以從目前卡住的工作找回對應文章,四種方法也能跨階段使用。
第一幕|先定問題與量尺(Day 1–5):先決定改善什麼、怎麼分工、拿什麼比較。
第二幕|把功能做出來,也驗清楚(Day 6–16):從目的、設計到實作與交付,每一步都有可核對的依據。
第三幕|讓方法離開作者(Day 17–22):查法、背景、檢查與隱藏依賴都留下,團隊才接得住。
第四幕|接上運行資料,安全處理問題(Day 23–28):從看見未完成的工作,到查因、修復、限制處置與核對排程成果。
第五幕|接續回饋,分開結帳(Day 29–30):讓結果與退回理由進入下一輪,再核對改善與代價。
參考資料與數字範圍:


 iThome鐵人賽
 看影片追技術